

Une fonctionnalité IA ne se juge pas au nombre de fois où on l'utilise, mais à ce que les utilisateurs pensent de ce qu'elle produit. Edifice l'a vérifié avec Screeb : le taux de satisfaction de son assistant de reformulation s'appuyant sur la technique du FALC (facile à lire et à comprendre) est passé de 34 % en juin à 79 % début octobre, en ajustant le prompt et le modèle de LLM à partir des retours.
Edifice édite des plateformes éducatives utilisées par des établissements scolaires du primaire et du secondaire partout en France. Romain Gentet, Lead Product Manager chez Edifice, a mis en place le dispositif de mesure. Il explique comment un simple survey, affiché quelques secondes après chaque texte généré, a permis à l'équipe de savoir ce qui fonctionnait, ce qui déplaisait, et dans quel sens corriger l'IA.
Pourquoi mesurer la satisfaction d'une IA change tout
Avec une fonctionnalité classique, on sait ce qu'elle va produire : le résultat dépend d'un algorithme que l'on maîtrise. Avec une IA générative, le résultat varie d'un usage à l'autre, et sa qualité est en partie subjective : un texte peut être correct sur le papier et pourtant ne pas convenir à celui qui doit le publier.
Pour Romain, le sujet n'est pas que la mesure soit plus difficile, c'est qu'elle devient plus importante :
« Je ne dirais pas qu'une feature IA est plus difficile à mesurer. Bien sûr il y a toujours des métriques de qualité de service classiques, mais la mesure de la satisfaction est plus importante dans la mesure où on ne maîtrise pas exactement ce que l'IA va produire, comme c'est le cas avec une fonctionnalité classique plus algorithmique. L'approche itérative m'a semblé d'emblée plus pertinente, mais aussi un bon moyen d'aller plus vite en production. »
— Romain Gentet, Lead Product Manager, Edifice
Le cas Edifice : une IA FALC pour parler à toutes les familles
Edifice édite des plateformes éducatives que des régions et des départements utilisent pour communiquer avec les familles. Dans les Hauts-de-France, la plateforme couvre les lycées et les écoles de la région, soit une audience de l'ordre de 400 000 parents environ.
Pour ces messages institutionnels, Edifice a intégré à son éditeur de texte une fonctionnalité IA de reformulation inspirée du FALC, le « facile à lire et à comprendre », une démarche d'inclusion d'origine européenne. L'auteur écrit son texte, l'IA lui propose une version plus simple. Elle est en production depuis le 24 mars sur les Hauts-de-France, puis a été généralisée aux autres plateformes.
Le défi tient à deux choses :
- L'acceptabilité : le texte proposé doit convaincre celui qui va le signer et l'envoyer.
- Le prompt : il faut un texte compréhensible, sans phrases trop hachées, au service de l'inclusion.
Sur ce type de message, impossible de savoir si l'IA tient la route sans demander l'avis de ceux qui l'utilisent.
Le dispositif : un survey Screeb juste après le texte généré
Edifice a configuré dans Screeb un survey in-app court qui s'affiche dans l'application, environ 10 secondes après que l'IA a rendu son texte. Il pose une première question, « Que pensez-vous du texte généré ? », avec un pouce en haut ou un pouce en bas. Viennent ensuite deux questions ouvertes : « Qu'est-ce qui est à améliorer ? » et un commentaire libre.

Le bon moment : quand le texte vient d'être lu
Le déclenchement est la décision qui compte le plus. Romain l'explique ainsi :
« Il m'a semblé plus pertinent de le faire juste après la lecture du texte proposé pour avoir un meilleur taux de réponse, un retour le plus à chaud possible afin d'avoir des retours le plus pertinent possible sur la formulation. Par ailleurs, il est nécessaire que les utilisateurs voient bien sur quoi le survey porte, car nous avons des dizaines d'autres fonctionnalités dans la plateforme. Un formulaire asynchrone était moins adapté pour ce cas de figure. »
— Romain Gentet, Lead Product Manager, Edifice
Un questionnaire envoyé plus tard aurait demandé à l'utilisateur de se souvenir d'un texte parmi des dizaines d'usages. Ici, la question arrive au moment où l'avis est le plus frais.
Un format qui limite la friction
Le choix du pouce haut ou bas suivi de deux questions ouvertes était, selon Romain, un moyen de générer le plus d'engagement dans le parcours de survey avec une question simple. Par ailleurs c'est un usage qui commence à s'installer dans les fonctionnalités de reformulation par IA. Les utilisateurs commencent à être habitués ce qui réduit encore la friction.
Le texte avant et après, joint à chaque réponse
Le survey ne remonte pas qu'une note. Edifice collecte, de façon pseudonymisée, le texte saisi par l'utilisateur et la version proposée par l'IA, rattachés à sa réponse. Ces retours sont ensuite exportés vers un agent qui en fait une analyse sémantique, pour vérifier que la reformulation tient la route par rapport à ce que disent les utilisateurs.
Quand un pouce bas arrive, l'équipe peut donc lire ce que l'utilisateur avait écrit, ce que l'IA a rendu, et ce qu'il en pense.
Ce que les retours ont appris à l'équipe
Dès les premières semaines, les retours ont mis en évidence un axe d'amélioration récurrent : le ton, jugé trop familier. Les commentaires étaient courts et concrets, comme « trop familier », « le niveau de langue » ou « le vouvoiement ». Le même constat remontait en parallèle par un département client, pour qui le vouvoiement est une recommandation du ministère de l'Éducation nationale.
Un formalisme qui dépend de qui écrit
En lisant les textes avant et après, l'équipe a compris que le registre attendu n'était pas le même pour tout le monde :
« On s'est aperçu que le formalisme attendu pouvait dépendre du type de communication et du profil de l'utilisateur. Un chef d'établissement va s'attendre à un texte plus formel. Un enseignant, quand il communique globalement adopte généralement un ton plus convivial. »
— Romain Gentet, Lead Product Manager, Edifice
Première surprise : les enseignants utilisaient la fonctionnalité plus que prévu, plus encore que les chefs d'établissement, pour leurs communications internes. Le ton inadapté ne relevait donc pas uniquement d'un prompt à améliorer, mais aussi du profil de l'utilisateur et de son public.
Des itérations sur le prompt et le modèle
Pour Edifice, la hausse de la satisfaction vient d'une série d'ajustements du prompt et du modèle de LLM utilisé derrière la fonctionnalité. Les retours servaient à trouver l'équilibre entre le format FALC et l'usage réel des utilisateurs, avec une bonne raison d'avancer par essais : chaque version pouvait être testée, puis validée ou abandonnée sur des données plutôt que sur une intuition.
C'est là que Screeb change la façon de travailler : l'équipe arbitre avec de vraies données, fait remonter des métadonnées utiles à l'analyse et gagne du temps pour tester et itérer.
Résultats : de 34 % à 79 % de satisfaction
La satisfaction mesurée par le survey est passée de 34 % en juin à 79 % sur la première quinzaine d'octobre.
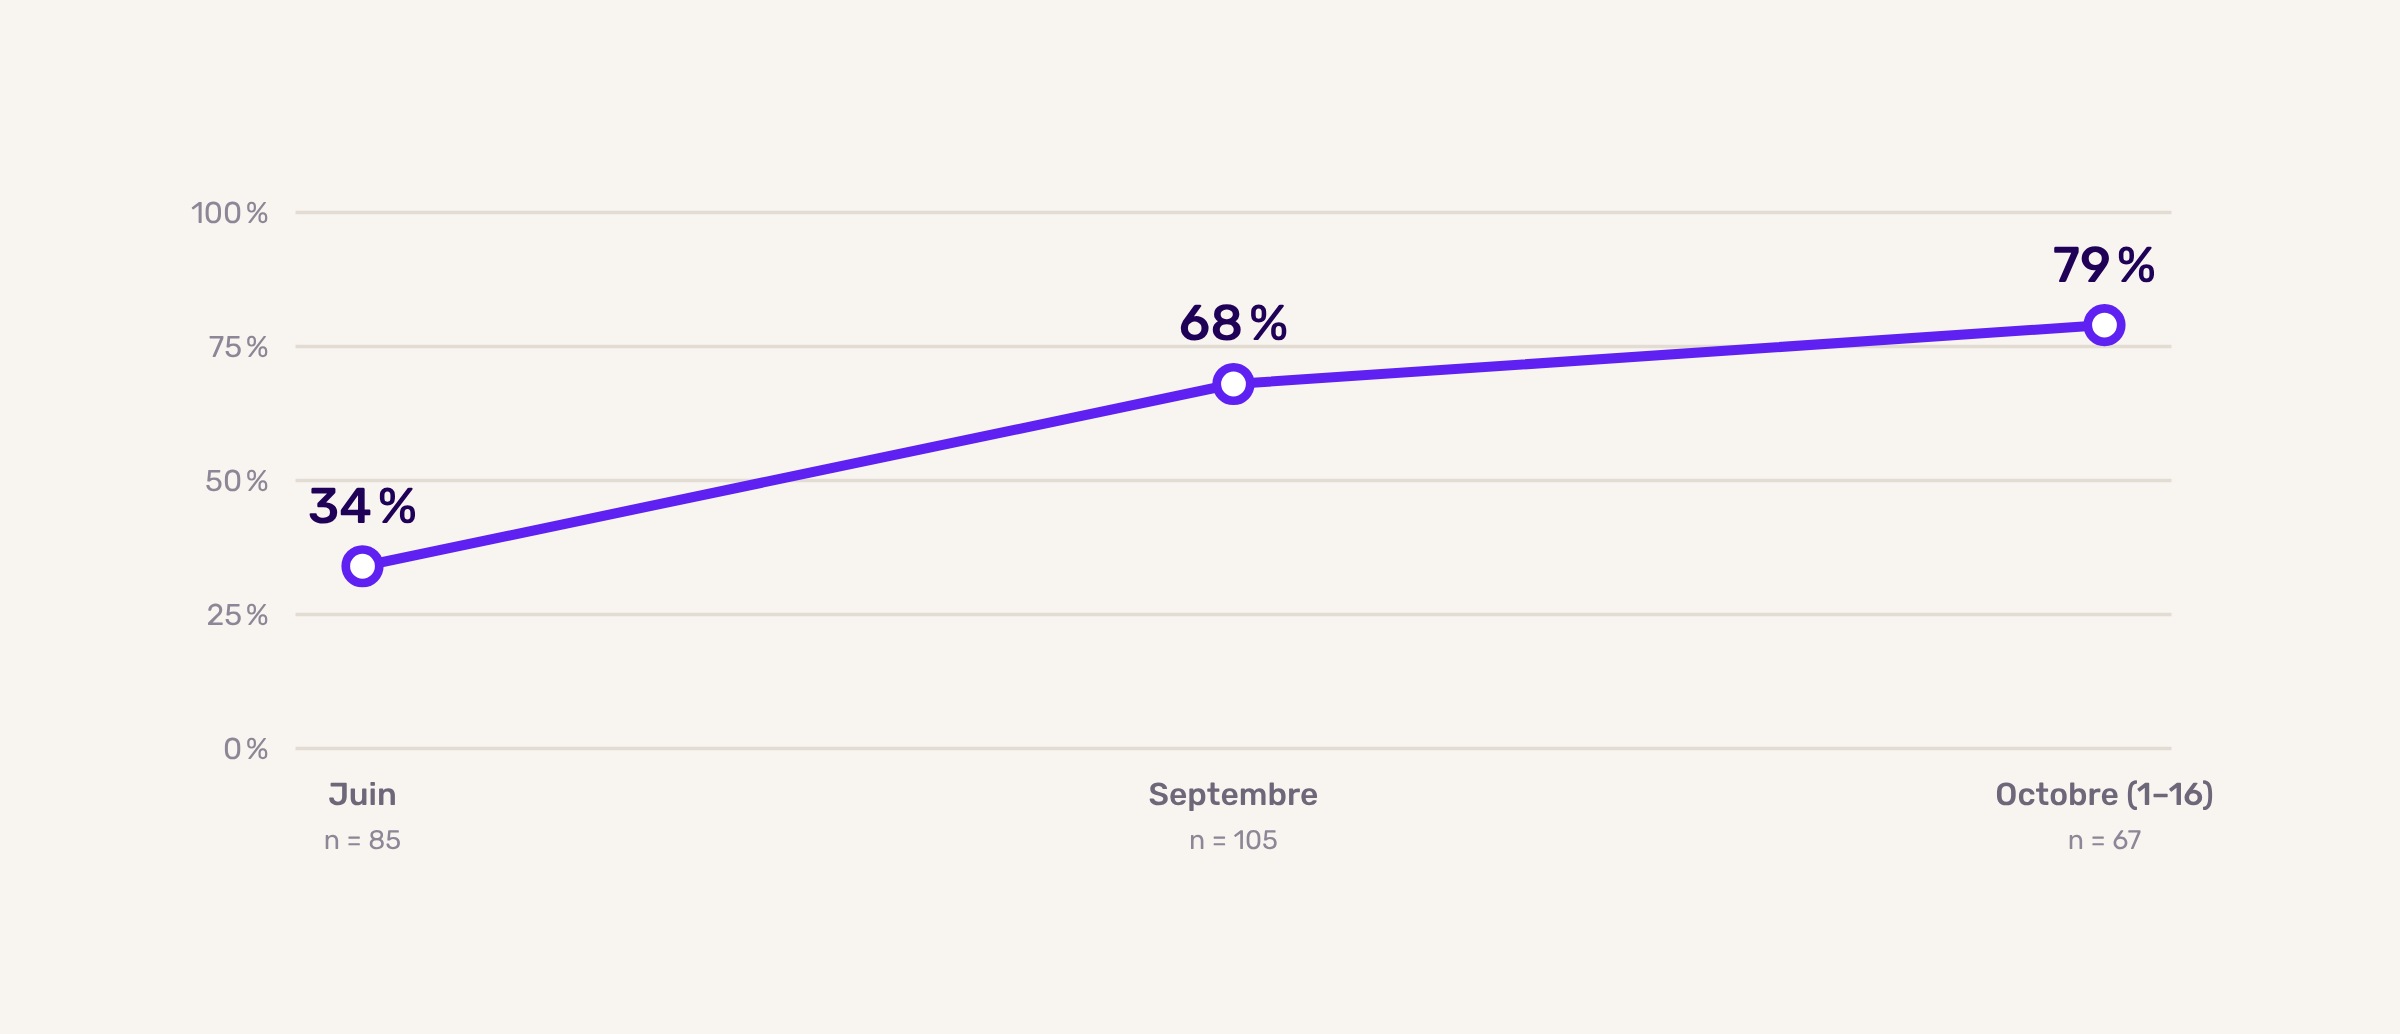
C'est un indicateur simple. Il mesure l'adhésion des utilisateurs au texte proposé, pas sa compréhension par les familles. De plus, seuls les utilisateurs qui répondent sont pris en compte : au lancement, environ un sur trois donnait son avis, avec une surreprésentation possible des plus mécontents. En revanche, la méthode de mesure reste identique d'une version à l'autre, ce qui permet de comparer les versions de l'IA et d'identifier celle qui recueille le plus d'avis favorables.

Secteur public : l'hébergement en France, un critère obligatoire
Quand un outil de mesure collecte les textes écrits par des agents de collectivités ou des enseignants, la question de l'hébergement des données se pose dès le premier jour. Pour Edifice, la réponse tient en une phrase :
« L'hébergement en France était tout simplement un critère obligatoire pour nous. »
— Romain Gentet, Lead Product Manager, Edifice
Ce critère n'est pas resté théorique : le RSSI d'Edifice a étudié les mentions de Screeb avant que l'équipe valide l'abonnement. Côté Screeb, les garanties tiennent en quelques points :
- Hébergement : 100 % en France, chez Scaleway et OVH.
- Juridiction : hors CLOUD Act.
- Chiffrement : tous les échanges sont chiffrés.
- Conformité : RGPD, ISO 27001 et AI Act.
- IA : l'analyse des feedbacks s'appuie sur une IA française, hébergée en Europe (Mistral AI).
Chez Edifice, les textes collectés pour comprendre les retours sont, eux, pseudonymisés.
Pour les équipes qui travaillent avec le secteur public, faire valider l'hébergement et les mentions de l'outil de mesure en amont est primordial, avant de configurer le premier questionnaire.
Mesurer la qualité de votre IA avec Screeb : la méthode d'Edifice
Depuis cette première expérience, la méthode a été reprise plusieurs fois chez Edifice. Le conseil de Romain à une équipe qui lance une fonctionnalité IA tient en une idée :
« Réfléchir à des data complexes pour mesurer le taux d'adoption ou la satisfaction par les données de navigation ou d'utilisation n'est pas toujours le plus pertinent. Dans certains cas, demander directement leur avis aux utilisateurs est plus utile et plus rapide à mettre en place. »
— Romain Gentet, Lead Product Manager, Edifice
Chaque étape s'appuie sur une fonctionnalité de Screeb :
- Déclenchez le survey sur un événement produit. Envoyez à Screeb un événement au moment voulu (par exemple « résultat IA affiché »), et le survey s'affiche juste après, avec le ciblage et les règles de fréquence qui évitent de sur-solliciter les utilisateurs. Il peut aussi être lancé directement depuis votre code, à l'instant précis souhaité.
- Gardez un format léger avec le builder de surveys. Une question de notation, puis une ou deux questions ouvertes : peu d'étapes à configurer, peu de friction pour l'utilisateur.
- Reliez la réponse à ce que l'IA a produit avec les hidden fields. Passez le texte d'entrée et le texte généré au lancement du survey : ils s'attachent à chaque réponse, sans que l'utilisateur les voie.
- Lisez les verbatims par thème avec l'analyse de contenu. Ton, niveau de langue, longueur : les commentaires désignent ce qu'il faut ajuster. La Content Analysis de Screeb fait ressortir les thèmes récurrents de vos retours, avec des exemples de réponses pour chacun.
- Modifiez, puis mesurez à nouveau dans les résultats du survey. Changez le prompt ou le modèle, et suivez la satisfaction mois après mois sur le même survey. Si vous envoyez la version du prompt ou du modèle comme propriété, vous pouvez aussi segmenter les résultats pour comparer avant et après.
FAQ : mesurer la satisfaction d'une fonctionnalité IA
Comment mesurer la satisfaction d'une fonctionnalité IA ?
En sollicitant les utilisateurs directement dans l'application, juste après l'affichage du résultat de l'IA. Edifice utilise un survey Screeb avec un pouce vers le haut ou vers le bas, suivi de questions ouvertes pour comprendre ce qui peut être amélioré.
Quel est le bon moment pour déclencher un survey sur une IA ?
Quelques secondes après la réponse de l'IA. Chez Edifice, le survey s'affiche environ 10 secondes après le texte généré, ce qui donne un retour à chaud et rattaché sans ambiguïté à la bonne fonctionnalité.
Faut-il des indicateurs d'usage complexes pour juger la qualité d'une IA ?
Pas toujours. Selon Romain, demander directement leur avis aux utilisateurs est dans certains cas plus utile et plus rapide à mettre en place que de construire des mesures d'adoption à partir des données de navigation.
Comment relier une note de satisfaction à ce que l'IA a produit ?
En joignant à chaque réponse le texte saisi par l'utilisateur et la version générée. Edifice les collecte de façon pseudonymisée, ce qui permet de comprendre pourquoi un résultat plaît ou déplaît et d'améliorer le prompt.
Peut-on mesurer la qualité d'une IA dans le secteur public ?
Oui, à condition de répondre aux exigences sur les données. Pour Edifice, l'hébergement en France était un critère obligatoire, et son RSSI a étudié les mentions de Screeb avant de valider l'abonnement. Screeb héberge ses données 100 % en France, chez Scaleway et OVH.
Conclusion : mesurer, c'est déjà améliorer
En quelques mois, Edifice est passé de 34 % à 79 % de satisfaction sur son IA de reformulation FALC, en s'appuyant sur une mesure simple : un survey Screeb affiché au bon moment, les textes avant et après pour comprendre chaque retour, et des ajustements de prompt et de modèle guidés par les utilisateurs. Le tout dans un cadre public, avec un hébergement en France exigé dès le départ.
Vous développez vous aussi une fonctionnalité IA ? Mesurez sa qualité dès le premier jour avec Screeb, et laissez vos utilisateurs vous dire comment l'améliorer.


